Rekaman 60 Menit Jadi Artikel: Alur Kerja Transkripsi Otomatis
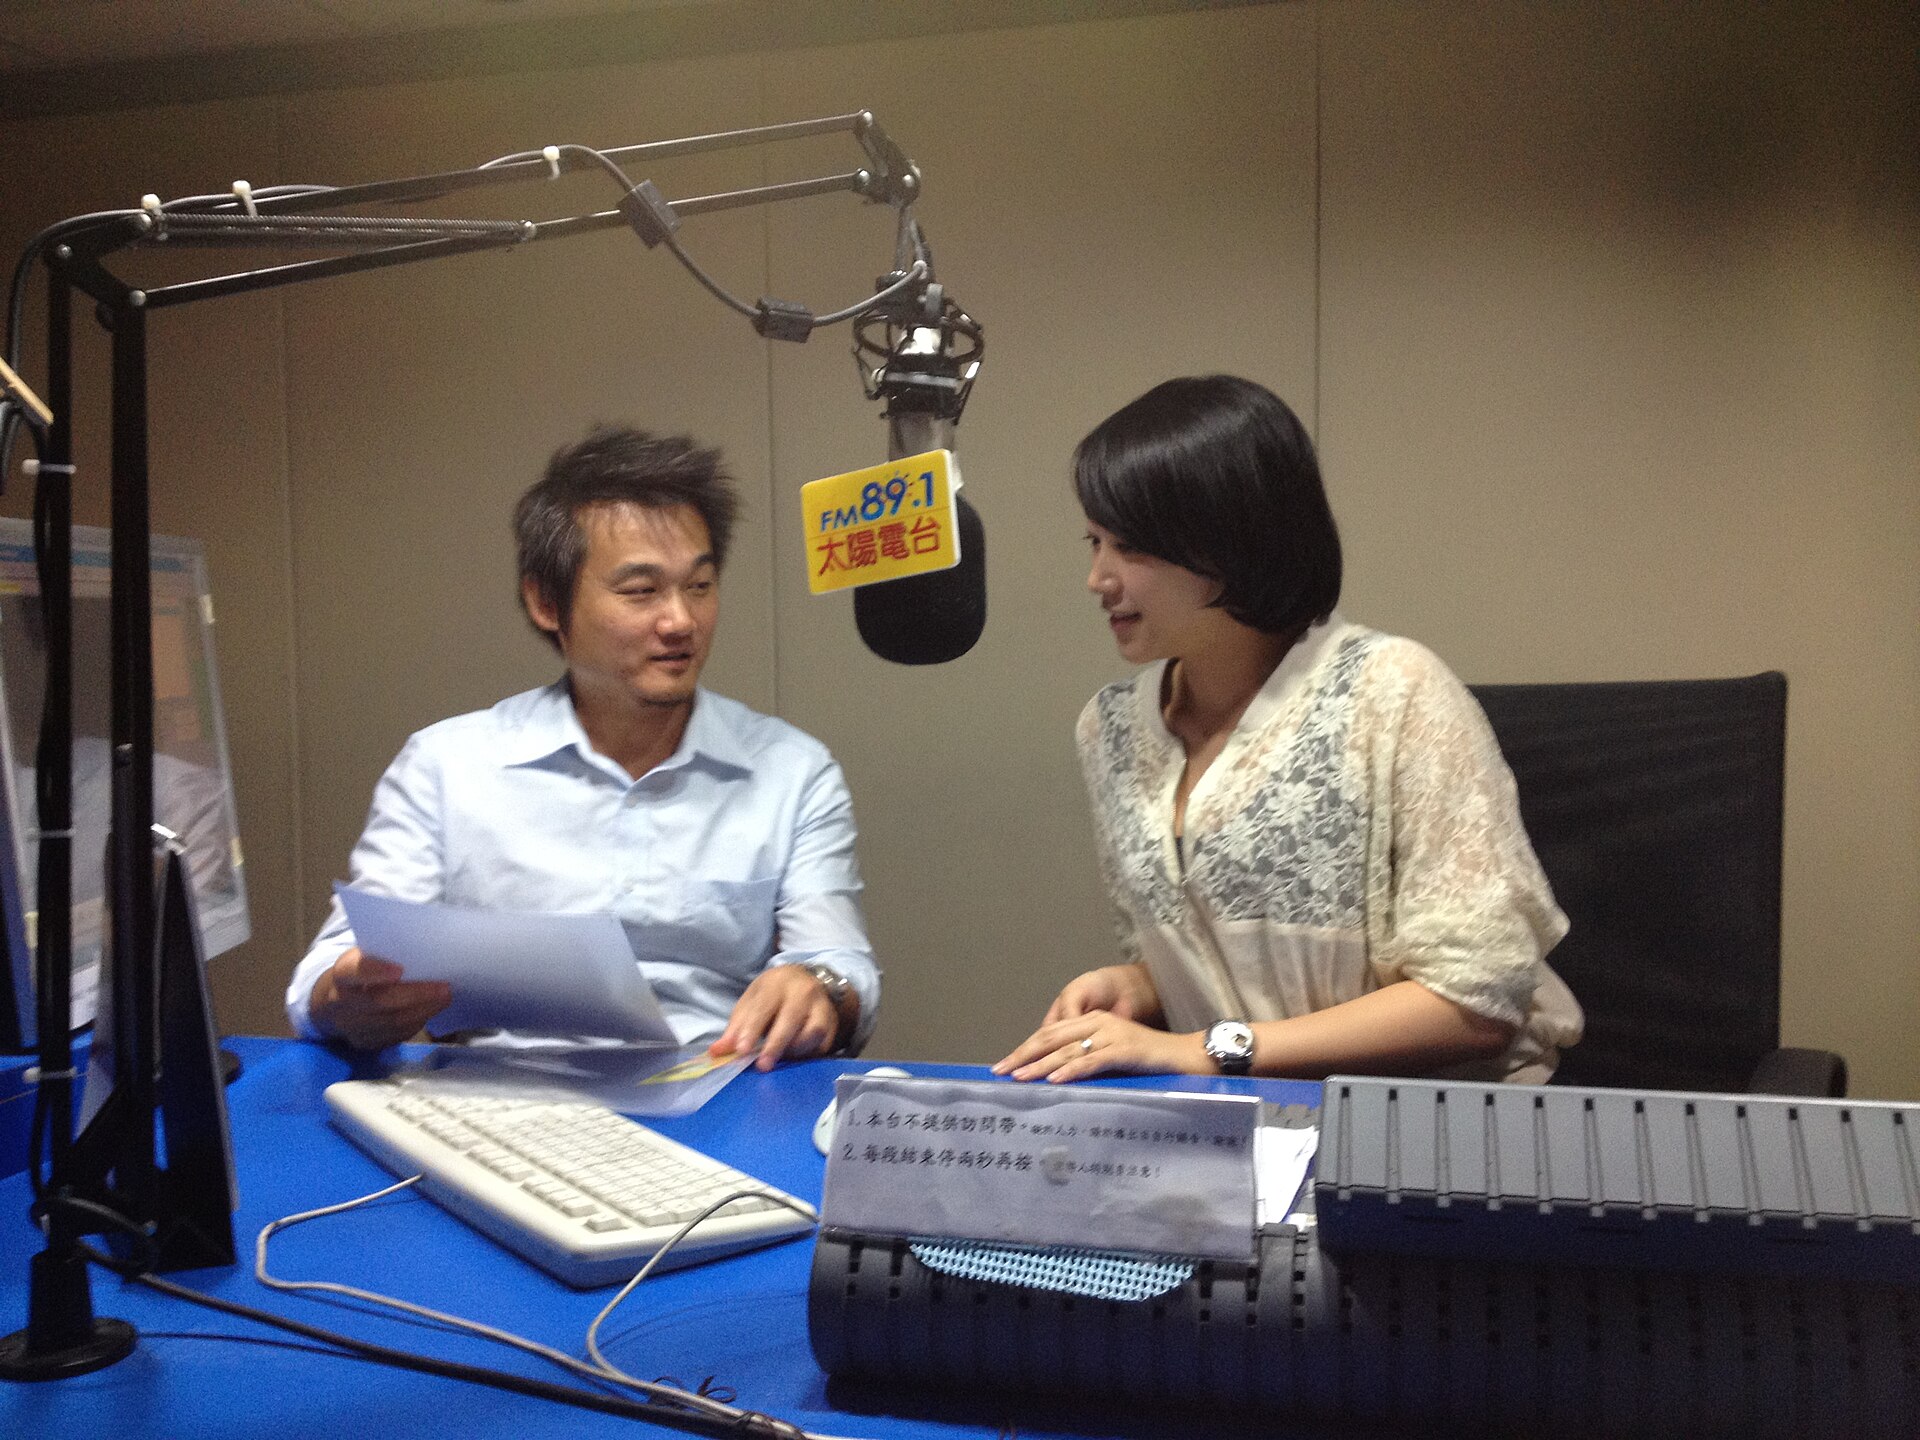
Setiap wawancara atau sesi podcast meninggalkan satu pekerjaan besar: menyulap satu jam percakapan menjadi teks yang bisa dikutip dan diterbitkan. Pekerjaan itu kini jauh lebih singkat. Mesin pengenal ucapan otomatis (automatic speech recognition, ASR) menghasilkan draf transkrip Bahasa Indonesia dalam hitungan detik sampai menit, lengkap dengan label pembicara dan penanda waktu. Namun transkrip mesin bukan produk akhir. Ia draf yang menyimpan dua risiko: salah dengar dan kutipan yang tak pernah diucapkan. Panduan ini menelusuri alur kerjanya, dari cara merekam sampai etika mengutipnya.
Dorongan Berubah di Ruang Redaksi dan Studio
Dorongan berubah datang dari dua arah. Survei Reuters Institute terhadap 326 pemimpin media di 51 negara menemukan 87 persen responden menilai AI generatif mulai mengubah ruang redaksi, dan 96 persen menempatkan otomatisasi dapur redaksi (penandaan arsip, transkripsi, penyuntingan) sebagai prioritas tahun berikutnya. Transkripsi menyentuh tiga hal paling sensitif: akurasi kutipan, privasi narasumber, dan tanggung jawab redaksi.
Kerangka etikanya sudah tersedia. Pada Januari 2025 Dewan Pers menerbitkan Peraturan Nomor 1 Tahun 2025 tentang Pedoman Penggunaan Kecerdasan Buatan dalam Karya Jurnalistik, berisi 8 bab dan 10 pasal. AI hanya alat bantu, produksi tetap di bawah kendali manusia, penggunaan AI yang berdampak signifikan harus dinyatakan jelas, dan tanggung jawab perusahaan pers tidak berkurang.
Merekam dengan Disiplin agar Mesin Tidak Salah Dengar
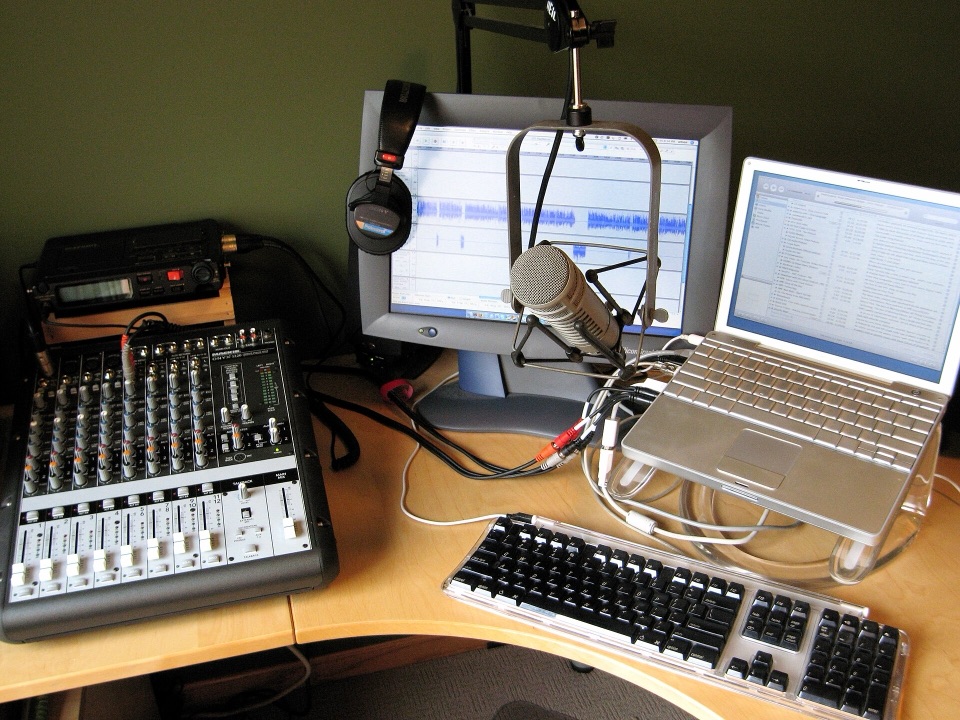
Kualitas transkrip ditentukan jauh sebelum berkas diunggah. Model ASR paling andal pada audio bersih: mikropon dekat, satu perangkat per pembicara bila memungkinkan, dan ruangan bernuansa lunak untuk menekan gema. Ujaran tumpang tindih adalah musuh utama. Pada dataset IDSV yang menghimpun variasi tutur Indonesia, segmen dengan pembicara saling menimpa menghasilkan word error rate 29,64 persen bahkan pada model terbaik yang diuji.
Kebiasaan kecil di awal rekaman berdampak besar. Sebutkan nama dan tanggal, lalu rekam persetujuan lisan seperti saran Reporters Committee for Freedom of the Press: identitas pewawancara, tujuan rekaman, dan kesediaan narasumber. Selain soal izin, ini menyediakan jangkar bunyi yang membantu pelabelan pembicara otomatis. Minta narasumber mengeja nama diri dan mengucapkan istilah kunci secara utuh; usaha satu menit di awal menghemat koreksi panjang.
Memilih Alat: Tiga Rute dan Empat Kriterianya
Pilihan alat terbagi tiga rute. Rute pertama menjalankan model terbuka sendiri. Varian turbo keluarga Whisper memangkas decoder dari 32 menjadi 4 lapis dan parameter ke 809 juta, sehingga berjalan sekitar delapan kali lebih cepat dengan penurunan akurasi kecil. Biaya komputasinya sekitar 0,05 sampai 0,15 dolar per jam audio, dan data tidak pernah meninggalkan perangkat Anda. Harganya adalah waktu dan keahlian teknis.
Rute kedua memakai API awan global, dengan tarif yang bervariasi tajam. Transkripsi batch OpenAI dipatok 0,0045 dolar per menit dan versi streamingnya 0,017 dolar per menit. Penyedia yang menjalankan Whisper di perangkat khusus menawarkan sekitar 0,02 dolar per jam dan memproses satu jam audio dalam 8 sampai 12 detik; model buatan sendiri 0,26 sampai 0,75 dolar per jam, sedangkan raksasa awan sekitar satu dolar per jam. Jebakan teknisnya: API Whisper membatasi berkas 25 MB dan tidak menyediakan pemisahan pembicara, jadi rekaman panjang harus dipotong lalu disatukan ulang.
Rute ketiga adalah layanan lokal berbasis pemakaian, termasuk pemain Indonesia yang menagih per transkrip dengan pembayaran rupiah. Klaim akurasinya jarang disertai benchmark terbuka, jadi uji dulu sebelum memindahkan seluruh arsip.
Akurasi Bahasa Indonesia paling sulit dipastikan karena tidak ada satu benchmark yang mencakup semua ragam tutur. Pada dataset IDSV, mms-1b-all mencatat word error rate 29,30 persen dan whisper-small 30,87 persen, sedangkan Whisper yang disetel ulang dengan data Indonesia turun ke 14,85 persen; studi lain melaporkan sekitar 19,8 persen setelah fine-tuning pada data Common Voice. Uji sendiri dengan potongan rekaman Anda: aksen dan campur kode paling sering salah. Model terbaru mulai menutup celah ini; salah satu rilis September 2026 mengklaim dukungan peralihan bahasa antarkalimat maupun dalam satu kalimat secara bawaan.
Harga mudah dibandingkan asal konsisten memakai satuan jam audio; fitur seperti pemisahan pembicara bisa menggandakan tarif dasar tanpa terasa. Privasi paling mahal risikonya. Dalam UU Nomor 27 Tahun 2022 tentang Pelindungan Data Pribadi, data biometrik termasuk data pribadi spesifik yang pemrosesannya menuntut dasar hukum dan persetujuan eksplisit, dengan sanksi administratif hingga 2 persen pendapatan tahunan dan ancaman pidana. Untuk wawancara sensitif, menjalankan model sendiri atau layanan dengan kebijakan retensi jelas lebih tenang. Kecepatan menjadi kriteria terakhir: mode batch cukup untuk wawancara, streaming relevan untuk takarir langsung.
Pelabelan Pembicara dan Disiplin Verifikasi
Transkrip yang belum diperiksa adalah draf, bukan rujukan. Dua pekerjaan wajib menanti: memastikan label pembicara benar dan tidak ada kalimat yang lahir dari imajinasi mesin. Pelabelan otomatis biasanya andal untuk dua sampai tiga pembicara, lalu menurun saat jumlah suara bertambah. Strategi termurahnya: rekam satu jalur per orang dan minta setiap peserta menyebut namanya saat mulai bicara.
Halusinasi adalah risiko yang kurang disadari. Studi "Careless Whisper" di konferensi FAccT 2024 menemukan sekitar 1 persen transkripsi Whisper memuat frasa yang sama sekali tidak ada di audio sumber, dan 38 persen di antaranya bermuatan berbahaya, dari tuduhan kekerasan sampai alamat situs palsu. Halusinasi lebih sering muncul pada rekaman berjeda panjang dan porsi diam besar, pola umum wawancara emosional. Mitigasinya sederhana: curigai kalimat yang muncul pada segmen tanpa suara.
Satu alat bantu akurasi lagi adalah glosarium: model Whisper menerima initial prompt berisi daftar istilah, dan banyak layanan punya kolom kosakata khusus. Menempelkan nama orang, tempat, dan istilah teknis sejak awal menekan kesalahan ejaan yang paling menyita koreksi.
Satu Transkrip, Banyak Produk
Transkrip yang rapi adalah bahan baku multi-produk. Artikel panjang disusun dari kerangka kutipan bertimestamp; potongan kutipan untuk media sosial tinggal disalin; berkas subtitle SRT atau VTT diekspor dari penanda waktu yang sudah ada; arsip teks memudahkan pencarian di kemudian hari. Untuk klip pendek, pilih momen yang memuat angka, analogi, atau emosi, lalu potong dengan tetap menyisakan pertanyaan penuntunnya. Memotong sampai makna berubah bukan penyuntingan, melainkan modifikasi kutipan.
Etika dan Hukum: Izin, Privasi, Batas Kutipan Mesin
Ketentuan merekam percakapan berbeda antar yurisdiksi: ada yang cukup dengan persetujuan satu pihak, ada yang menuntut persetujuan semua pihak. Reporters Committee for Freedom of the Press menyarankan jurnalis memperlakukan izin lisan yang terekam sebagai standar aman.
Pedoman Dewan Pers menambah rambu yang relevan bagi kreator: AI tidak boleh menggeser tanggung jawab, konten berbantuan AI yang berdampak signifikan wajib diberi keterangan, dan privasi harus dihormati. Sulih suara dan sintesis suara dari sosok tertentu wajib seizin pemilik suara asli.
Batas mengutip transkrip mesin lugas: tidak ada kutipan langsung yang layak terbit sebelum dicocokkan dengan audio. Menghaluskan ucapan yang terputus boleh, mengubah maknanya tidak. Dewan Pers juga mendorong penguatan perlindungan karya jurnalistik dari pengambilan tanpa izin, termasuk untuk pelatihan model AI. Praktisnya: bersihkan elemen pihak ketiga seperti musik latar sebelum publikasi, lalu perlakukan transkrip utuh sebagai dokumen berisi data pribadi.
Alur Kerja 60 Menit: Artikel dan Klip dari Satu Sesi
Berikut gambaran alur kerja dari rekaman 60 menit dengan dua narasumber dan dua jalur audio.
- Sebelum merekam: siapkan dua perekam, rekam perkenalan dan persetujuan, minta ejaan nama.
- Setelah sesi: unggah kedua jalur, pilih bahasa Indonesia, aktifkan pemisahan pembicara bila tersedia, tempelkan glosarium istilah.
- Tunggu pemrosesan. Di layanan tercepat, satu jam audio selesai dalam belasan detik; di API batch standar sekitar satu menit.
- Rapikan draf: koreksi nama, angka, dan istilah; periksa label pembicara di titik perpindahan.
- Verifikasi kutipan langsung dengan menyetel ulang audio pada timestamp terkait, lalu tandai momen terkuat sebagai kerangka tulisan.
- Tulis artikel dari kerangka itu, ekspor subtitle, potong dua sampai tiga klip pendek dengan konteks yang tetap utuh.
- Arsipkan audio terenkripsi beserta transkrip dengan kebijakan retensi yang jelas.
Outlook: Model Multimodal yang Mendengar Sambil Bekerja
Arah teknologi beberapa tahun terakhir jelas: dari transkripsi berkas menuju pemahaman percakapan secara langsung. Pada September 2026 Meta memperkenalkan Muse Voice Transcribe, model pengenal ucapan real-time dengan pemisahan pembicara untuk lebih dari 20 orang dan peralihan bahasa yang mulus; model itu divalidasi pada 25 bahasa termasuk Indonesia, dipatok sekitar 0,18 dolar per jam, dan mencatat tingkat kesalahan 3,1 persen dalam pengujian Artificial Analysis. Nvidia merilis model serupa secara terbuka dengan kapasitas delapan pembicara dan tingkat kesalahan 14,72 persen, sekitar 24 persen lebih baik dari pesaing terdekatnya.
Implikasinya bukan penggantian pekerjaan, melainkan pergeseran: takarir langsung, arsip yang otomatis bisa dicari, dan draf yang siap begitu sesi berakhir. Yang tersisa, dan justru menjadi pembeda, adalah penilaian manusia: siapa yang layak dikutip dan konteks apa yang perlu disertakan.
Penutup
Transkripsi otomatis memindahkan beban kreator dan jurnalis dari mendengarkan ulang menjadi menyunting dan memverifikasi. Perubahan itu nyata, tetapi tidak menghapus kewajiban lama: izin sebelum merekam, verifikasi sebelum mengutip, dan kehati-hatian sebelum mempublikasikan suara orang lain. Pilih alat dengan menimbang akurasi Bahasa Indonesia, privasi, dan biaya per jam audio; perlakukan transkrip mesin sebagai draf; simpan audio sebagai rujukan. Dengan begitu, satu jam percakapan berubah menjadi bahan yang layak dipercaya.
Sumber
- Journalism, Media and Technology Trends and Predictions 2025 (Reuters Institute)
- Pedoman penggunaan AI dalam karya jurnalistik Dewan Pers (detikcom, 2025)
- Penggunaan AI dalam jurnalistik harus patuhi kode etik (Dewan Pers, 2025)
- Enhancing Indonesian Automatic Speech Recognition (arXiv, 2024)
- Careless Whisper: Speech-to-Text Hallucination Harms (arXiv, FAccT 2024)
- Meta releases Muse Voice Transcribe (GIGAZINE, 2026)
- Speech-to-Text API Comparison 2026 (DEV Community)
- OpenAI API Pricing
- The Reporter's Recording Guide (RCFP)
- UU No. 27 Tahun 2022 tentang Pelindungan Data Pribadi (JDIH BPK RI)
Coba Vokara
Ubah rekaman rapat menjadi transkrip dan notulen rapi dalam hitungan menit.